
Als ich mit Indrayala begonnen habe, war die Ausgangsidee vergleichsweise einfach: Eine lokale Wissens-Infrastruktur, in der Daten, Dokumente und Methoden zusammengehören. Offen, replizierbar und ohne zentrale Plattform, der man Daten und Kontrolle überlassen muss.
Daraus ist inzwischen eine weitergehende Frage entstanden:
Was wäre, wenn nicht nur Daten und Dokumente, sondern auch Methoden als explizites, replizierbares Wissen dargestellt werden könnten?
Die Intelligenz, die zu ihrer Entdeckung und Strukturierung notwendig war, steckt dann nicht in einem mitreisenden Modell oder Programm. Ihr Ergebnis steckt in der Struktur: in Beziehungen, Method Cards, Regeln und anderen semantischen Artefakten.
Ausführung und notwendige weitere Inferenz bleiben Sache des jeweiligen Knotens.
Diese Frage verändert die Architektur von Indrayala.
Wissen und Methode
Eine Methode beginnt häufig als Narrativ. Menschen beschreiben, welche Informationen sie benötigen, worauf sie achten, welche Zusammenhänge sie herstellen und wie sie aus Beobachtungen zu Bewertungen oder Entscheidungen kommen.
Für Software ist dieses Wissen zunächst schlecht ausführbar. Für ein großes Sprachmodell dagegen ist es erstaunlich gut zugänglich.
Man könnte deshalb bei jeder neuen Aufgabe das Narrativ, die Daten und den aktuellen Kontext an ein Modell schicken und es um eine Antwort bitten. Genau so funktionieren heute viele KI-Anwendungen.
Indrayala versucht den umgekehrten Weg.
Das Sprachmodell soll die Methode nicht immer wieder neu interpretieren. Es soll zunächst dabei helfen, aus dem Narrativ eine explizite semantische Struktur zu gewinnen.
In Indrayala nennen wir diese Struktur eine Method Card.
Method Narrative↓Discovery / Authoring↓Method Card↓Semantic Compiler↓Executable Semantics
Die Method Card ist dabei kein Programm. Sie beschreibt deklarativ, welches Wissen eine Methode benötigt, welche Beziehungen relevant sind, was geprüft oder bewertet werden soll und an welchen Stellen Interpretation notwendig ist.
Erst ein Compiler übersetzt diese Beschreibung in eine ausführbare Repräsentation.
Kompilierte Intelligenz
Hier wird die Idee interessant.
Ein erheblicher Teil einer Methode benötigt überhaupt kein Sprachmodell.
Bekannte Beziehungen können traversiert werden. Prädikate können ausgewertet, Werte berechnet, Evidenz geprüft und Regeln angewendet werden.
Solche Teile einer Method Card lassen sich in eine beschränkte Regelsprache übersetzen – beispielsweise in eine Datalog-artige Repräsentation.
Diese Sprache ist absichtlich kein allgemeines Programmierwerkzeug.
Sie kann Beziehungen auswerten und Schlussfolgerungen ziehen. Sie kann aber nicht plötzlich Dateien löschen, einen Prozess starten oder irgendwo im Netz einen Dienst aufrufen.
Die Beschränkung ist kein Versprechen, sondern eine Eigenschaft der Sprache.
Das ist wichtig, weil Indrayala Wissen zwischen autonomen Knoten repliziert.
Eine Method Card darf eine Systemgrenze überschreiten. Ausführungsautorität nicht.
Der empfangende Knoten interpretiert und kompiliert sie ausschließlich in lokal zulässige, by construction beschränkte Ausführungsformen. Eine importierte Methode kann dadurch keine Fähigkeiten einschleusen, die der lokale semantische Runtime nicht ohnehin zur Verfügung stehen.
Das löst allerdings nur die technische Hälfte des Vertrauensproblems.
Eine perfekt beschränkte Regel kann fachlich falsch sein. Sie kann unpassende Zusammenhänge herstellen, falsche Bewertungen erzeugen oder den Fokus auf Dinge lenken, die für den empfangenden Wissensraum nicht relevant sein sollten.
Execution safety is structural. Semantic trust is a governance decision.
Der empfangende Knoten muss deshalb nicht nur prüfen, ob eine Methode sicher ausführbar ist. Er entscheidet unabhängig davon, welchen epistemischen Status sie in seinem Knowledge Space erhält und ob sie dort überhaupt angewendet werden darf.
Aus „Replicate Knowledge, Not Code“ werden damit zwei Grenzen:
Replicated knowledge cannot acquire capabilities outside the local runtime.
Replicated knowledge does not acquire authority merely by crossing the boundary.
Der semantische Rest
Nun lassen sich Methoden natürlich nicht vollständig in Regeln verwandeln.
Ein Satz in einem Dokument kann mehrdeutig sein. Eine Beobachtung muss einem fachlichen Konzept zugeordnet werden. Ein Zusammenhang kann neu oder unsicher sein.
Es bleibt ein semantischer Rest.
Und genau hier kommt KI wieder ins Spiel.
Method Card↓Semantic Compiler↓┌───────────────────┬───────────────────┐│ ausführbar │ semantischer Rest ││ │ ││ Regeln │ Interpretation ││ Prädikate │ Mehrdeutigkeit ││ Traversierung │ neues Konzept ││ Bewertungen │ offene Semantik │└───────────────────┴───────────────────┘↓ ↓Runtime Nano-Modell
Das Nano-Modell bekommt dabei nicht den vollständigen Fall mit der Aufforderung: „Löse das Problem.“
Es bekommt eine möglichst kleine semantische Aufgabe.
Zum Beispiel: Eine konkrete Beobachtung soll einem bereits bekannten Konzept zugeordnet werden. Das ist eine Form von BIND.
Reicht das lokale Modell dafür nicht aus, kann die Runtime die ungelöste Aufgabe an ein leistungsfähigeres Modell weitergeben.
Aber sie gibt nicht den ganzen Fall erneut ab.
Bereits aufgelöste Beziehungen, Bindings, Bewertungen und andere semantische Zustände bleiben erhalten.
Escalation changes the executor, not the semantic state.
Damit bekommt auch eine ältere Grundidee von Indrayala eine präzisere Bedeutung:
Intelligence should be invested once and executed many times.
Vom Wissensspeicher zum semantischen Workspace
Aus diesen Überlegungen hat sich auch das Bild des Systems verändert.
Indrayala ist nicht mehr nur eine Infrastruktur, in der strukturierte Daten, Dokumente und Regeln zusammenleben.
Es entwickelt sich in Richtung eines ausführbaren semantischen Workspace.
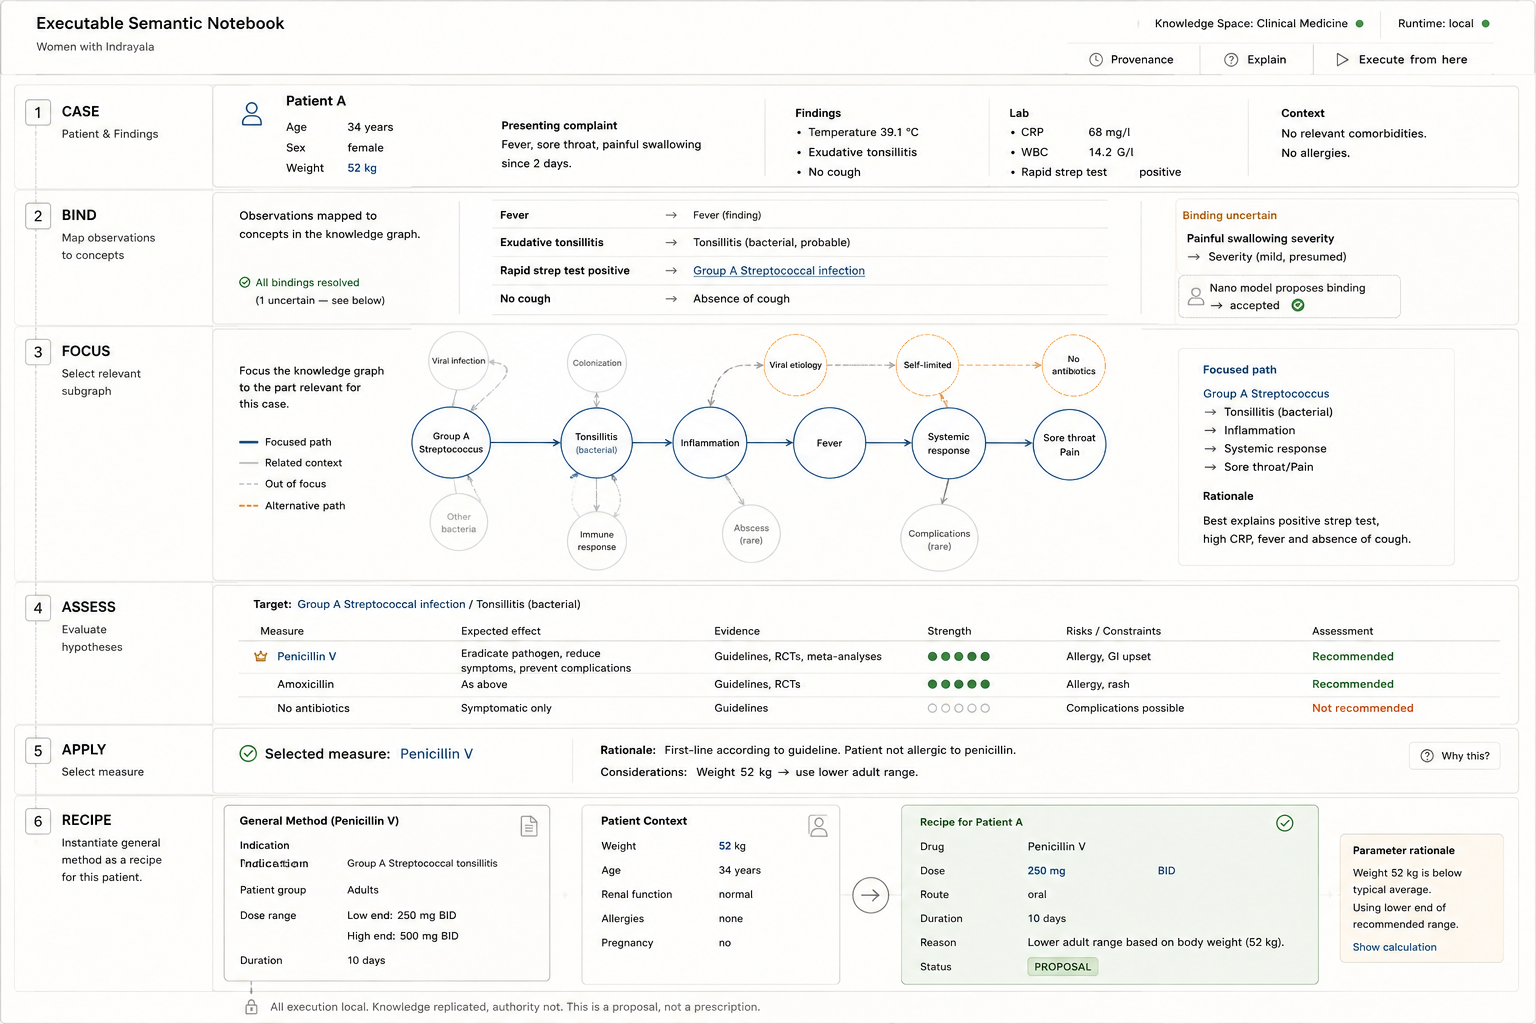
Ein konkreter Fall adressiert allgemeines Wissen. Beobachtungen werden an semantische Konzepte gebunden (BIND). Daraus entsteht ein für die Methode relevanter semantischer Index. Aus einem möglicherweise großen Wissensraum wird ein Ausschnitt fokussiert (FOCUS). Dieses Wissen wird anschließend wieder auf den konkreten Fall angewendet (APPLY).
Case / Query / Dataset↓BIND↓Semantic Index↓FOCUS↓APPLY↓Implications / Suggestions / Actions
Entscheidend ist dabei, dass dieser Prozess sichtbar und unterbrechbar bleibt.
Ein Mensch – oder ein Agent – muss fragen können:
Warum wurde diese Beobachtung so interpretiert?
Warum ist dieser Zusammenhang im Fokus?
Warum wurde eine Alternative nicht berücksichtigt?
Und schließlich: Was ändert sich, wenn ich eine frühere Annahme korrigiere?
In diesem Sinn ähnelt der entstehende Workspace weniger einem Chatbot als einem ausführbaren semantischen Notebook. Man kann einen früheren Zustand verändern und sinngemäß sagen: Execute from here.
Eine ökonomische Hypothese
Hinter dieser Architektur steckt schließlich eine Hypothese über die Kosten von KI.
Heute wird Intelligenz überwiegend pro Vorgang bezahlt. Neuer Fall, neuer Kontext, neue Inferenz.
Indrayala versucht, einen wachsenden Teil dieser Intelligenz in wiederverwendbare Strukturen zu verschieben: Knowledge Spaces, Beziehungen, Method Cards, Bindings, Assessments und ausführbare Regeln.
Das kostet zunächst ebenfalls Intelligenz. Große Modelle können beim Entdecken und Strukturieren sogar besonders wertvoll sein.
Aber diese Arbeit bleibt erhalten.
Mit jedem neuen Fall stellt sich deshalb die Frage: Wie viel davon können wir inzwischen schon ausführen – und wie groß ist der semantische Rest, für den wir tatsächlich wieder ein Modell benötigen?
Wenn dieser Rest mit wachsendem Wissen kleiner wird, sinkt der marginale Inferenzaufwand.
Ob das tatsächlich funktioniert, ist keine Glaubensfrage. Es lässt sich messen.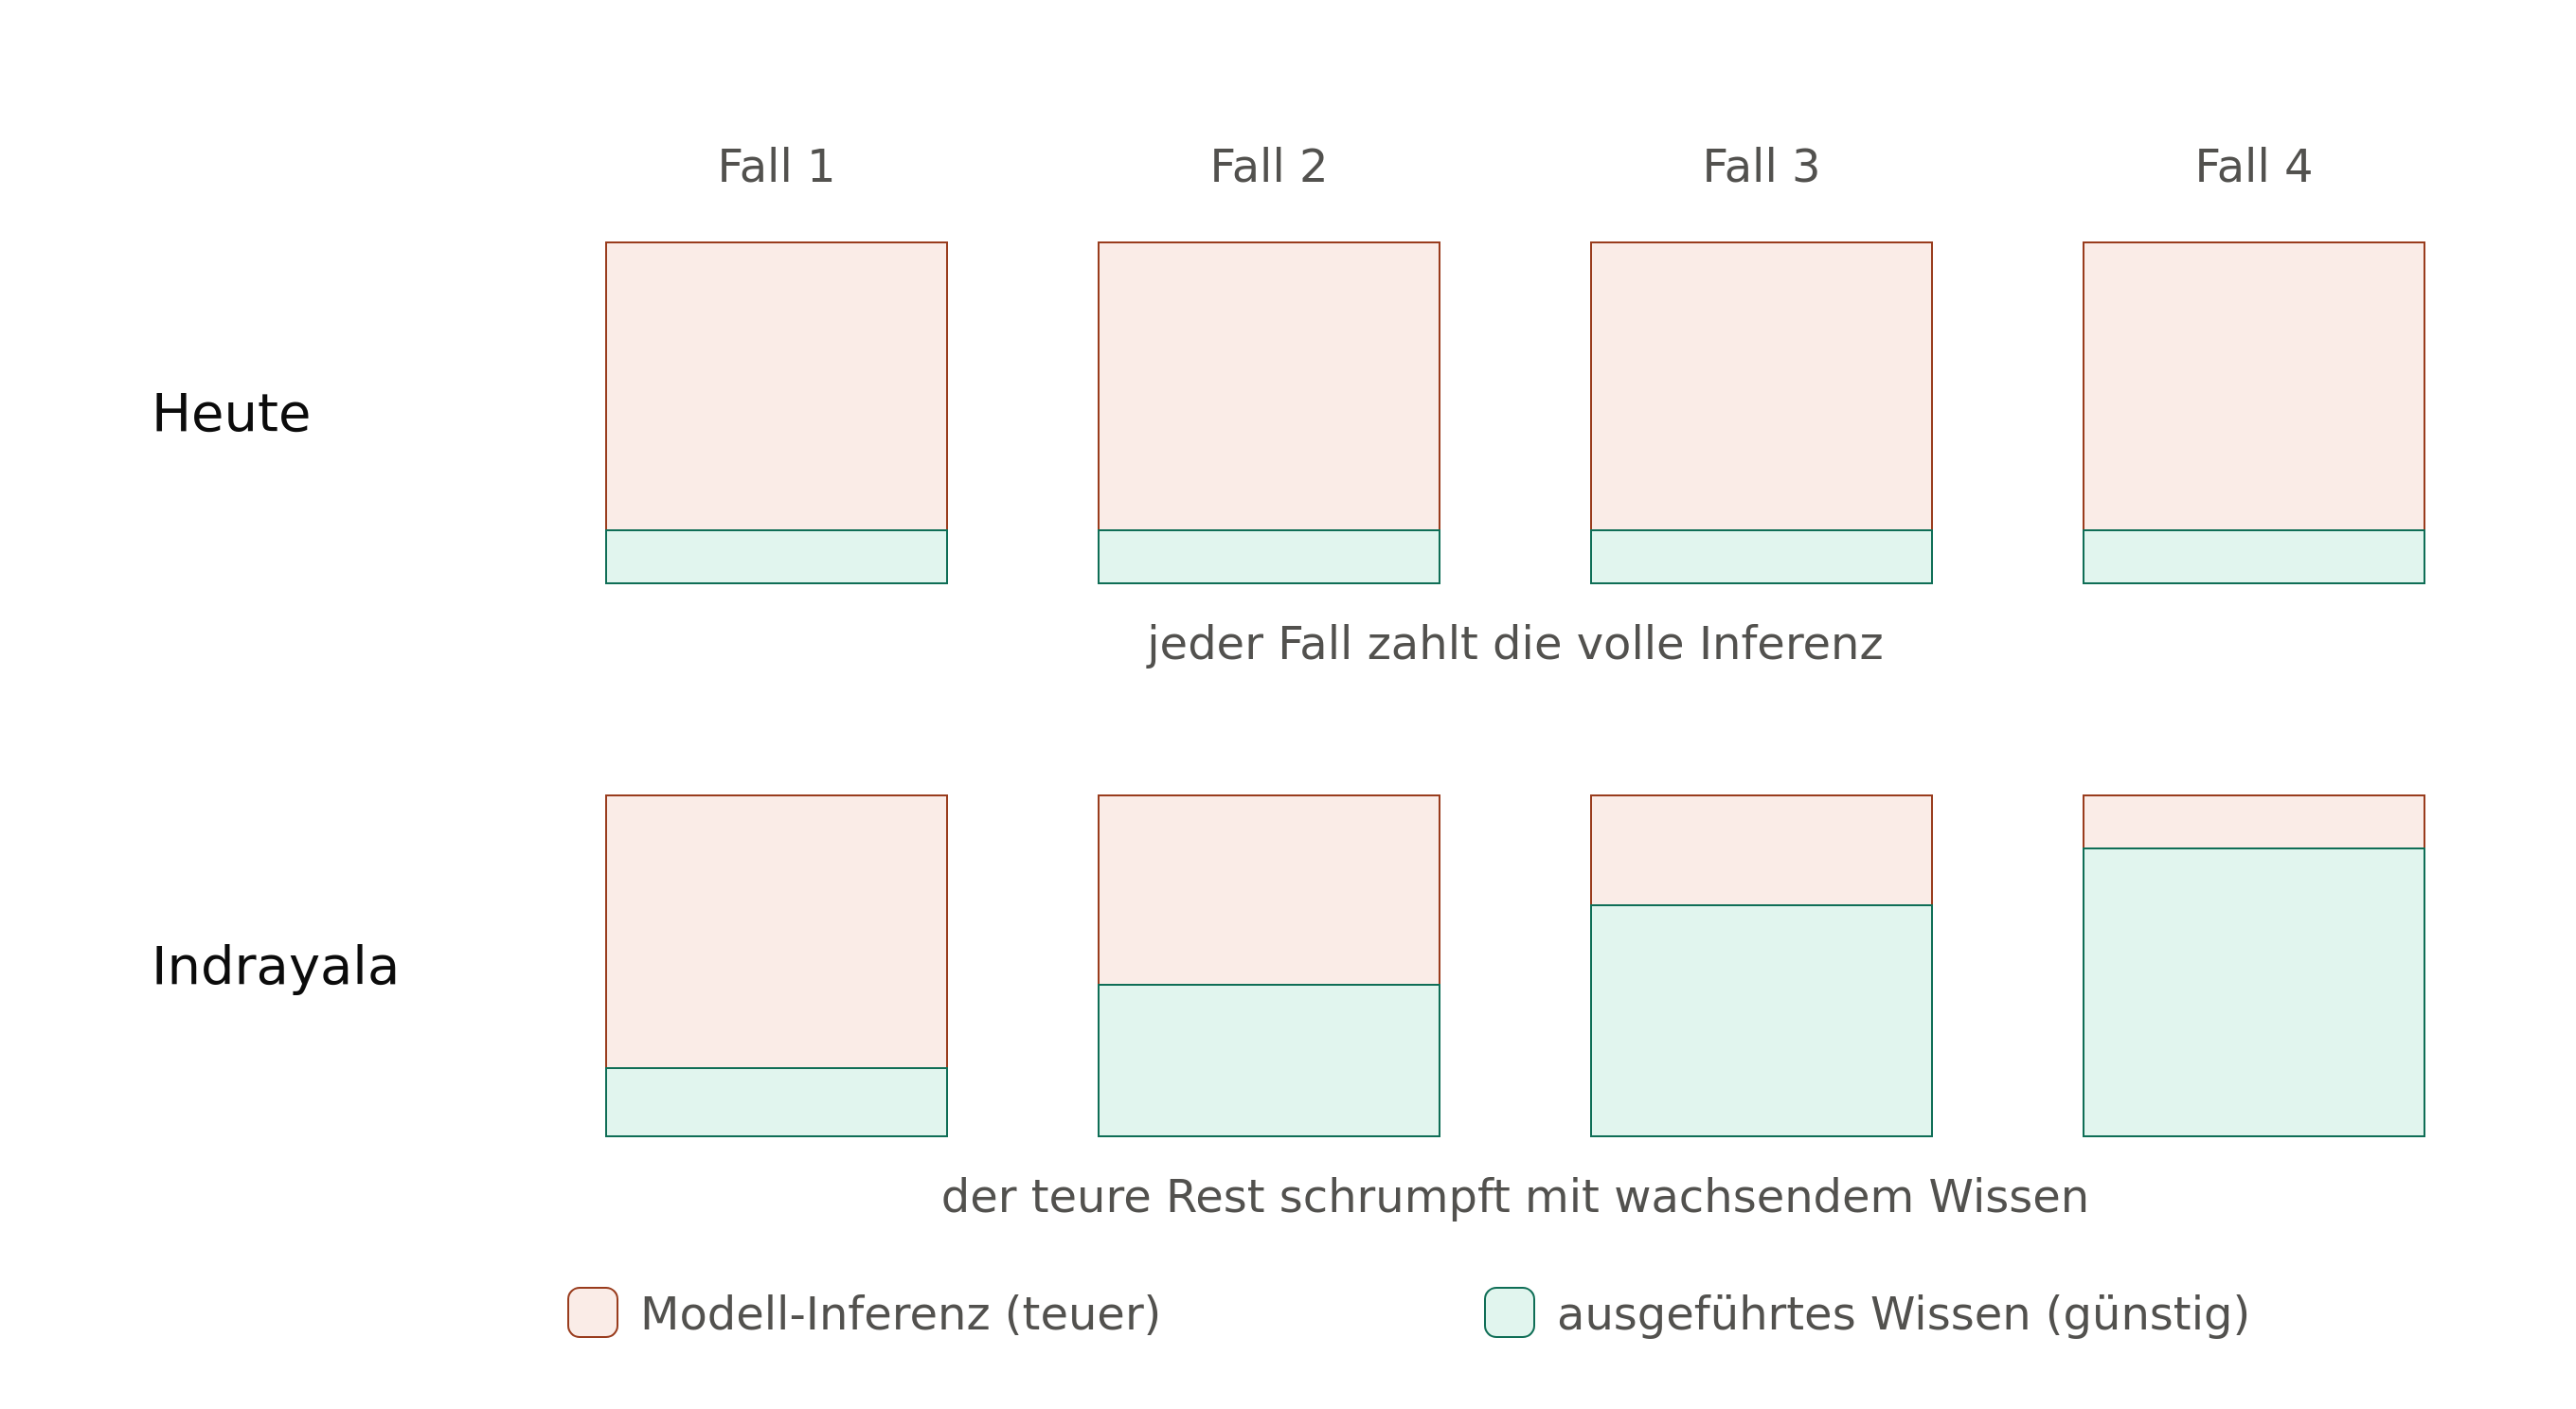
Wo Indrayala heute steht
Ein Teil der dafür notwendigen Infrastruktur existiert bereits: lokale schema-gesteuerte Anwendungen, SQLite/APSW, Analytics, Dokumentenintegration, Peer-to-Peer-Replikation, Governance, semantische Accessors und Grundlagen für Method Cards und Context Resolution.
Andere Teile sind noch Forschungsarbeit.
Dazu gehören insbesondere die weitere Semantik und Ausführung von Method Cards und ihr Compiler. Wir untersuchen außerdem, welche semantischen Konstrukte der vorhandenen Sprache fehlen, wie zuverlässig konkrete Beobachtungen an Wissen gebunden werden können, wie FOCUS in dichten und zyklischen Wissensräumen funktioniert und wie stark sich der Bedarf an Modellinferenz tatsächlich reduzieren lässt.
Datalog ist dabei eine naheliegende Möglichkeit für beschränkte Regelausführung, aber keine bereits getroffene Architekturentscheidung.
Das ist Absicht.
Indrayala soll seine semantische Sprache und Ausführungsarchitektur nicht am Reißbrett erfinden. Neue Konstrukte sollen aus konkreten Fällen und Experimenten entstehen und erst dann verallgemeinert werden.
Discovery precedes abstraction.
Vielleicht lässt sich die erweiterte Vision deshalb inzwischen in vier Sätzen zusammenfassen:
Wissen soll ausführbar werden.
Methoden sollen als Wissen zwischen souveränen Systemen beweglich sein, Ausführungsautorität dagegen nicht.
KI soll den semantischen Rest bearbeiten, nicht immer wieder das bereits Gelöste.
Und Menschen sollen jederzeit sehen und verändern können, wie aus einer Beobachtung eine Interpretation und aus einer Interpretation eine Handlung geworden ist.

